Este guia analisa como estruturar um Scenario Automação para integrar instrumentos, software e processos com rastreabilidade e segurança. Em seguida, apresenta de forma objetiva o contexto de automação industrial, a lógica de cenários (pré-condições, gatilhos e exceções) e como preparar requisitos operacionais, validação e governança para reduzir retrabalho e falhas.
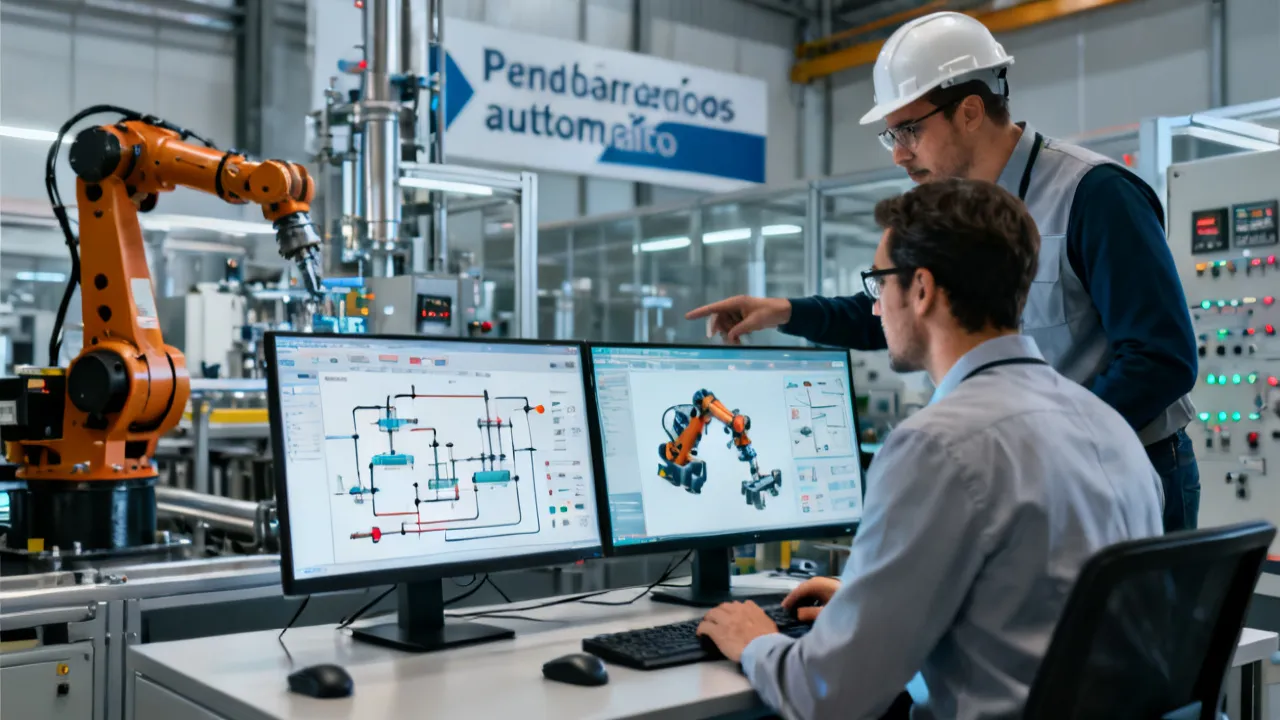
Ao desenhar um Scenario Automação, o objetivo não é apenas “automatizar tarefas” ou “encadear comandos” até o processo chegar a algum ponto. O objetivo real é padronizar decisões operacionais e garantir que a linha (ou o processo) execute ações corretas sob condições definidas, com comportamento previsível quando algo muda, degrada ou falha. Em termos de engenharia, o scenario funciona como um “contrato operacional” entre o que o processo precisa fazer e as condições sob as quais essa necessidade se torna válida.
Para o cenário funcionar de modo consistente, ele deve integrar: (i) sinais e medições confiáveis (com diagnóstico e avaliação de qualidade), (ii) regras explícitas de tomada de decisão (com critérios e temporizações), (iii) tratamento de exceções (falhas de sensor, perda de utilidades, eventos fora de ordem, inconsistências de estado), e (iv) rastreabilidade do que aconteceu e por quê (trilha de auditoria e contexto das variáveis relevantes). Se qualquer um desses pilares falhar, o cenário tende a virar uma “lista de comandos com alarmes”, difícil de manter e propensa a comportamentos não intencionais.
Do ponto de vista de um especialista de indústria, essa abordagem reduz variação entre turnos, melhora a qualidade do comissionamento e acelera melhorias contínuas. Quando cada operador interpreta sinais de forma diferente, quando cada equipe “contorna” problemas do jeito que sabe, ou quando ajustes de regras são feitos sem controle, a planta passa a operar com uma espécie de “automações paralelas” construídas informalmente. Cenários bem desenhados invertem essa dinâmica: transformam o procedimento (o saber tácito) em decisão formal e verificável.
Na prática, quando o scenario é modelado corretamente, você passa a enxergar a automação como um sistema de intenção operacional (o que precisa ser feito, sob quais condições e com quais garantias), e não como uma sequência rígida de comandos. Isso é especialmente relevante quando existem mudanças sazonais de demanda, variações de matéria-prima, limitações de utilidades (ar, vapor, energia, água gelada, nitrogênio etc.) e necessidade de conformidade de processo (por exemplo, requisitos de rastreabilidade, controle de lote, limites de qualidade, validação de tempos e parâmetros).
Importante: este texto não utiliza informações de “preço” ou “fornecedores” específicas porque os dados não foram fornecidos no enunciado. Ainda assim, a metodologia aqui descrita mostra exatamente como levantar custos, comparar opções de suprimento e escolher integradores com base em critérios técnicos e de risco. E mais: ela mostra como garantir que a “entrega” do integrador não seja só a implementação do fluxo principal, mas sim a qualidade do conjunto (diagnóstico, exceções, logs, comissionamento e governança).
Automação industrial evoluiu de lógica fixa para orquestração orientada a eventos e estados. Hoje, sensores geram sinais; controladores processam estados; sistemas supervisórios (SCADA) e plataformas de fabricação (MES/APS/LIMS em alguns contextos) coordenam execução e rastreiam histórico e desempenho. Nesse panorama, o Scenario Automação funciona como um “roteiro” operacional: ele descreve gatilhos (quando iniciar), condições (o que deve ser verdadeiro), ações (o que executar) e tratamento (o que fazer quando falha, degrada ou foge do padrão).
Essa estrutura é alinhada à forma como indústrias tratam segurança e confiabilidade: não basta que a máquina “execute”; ela precisa responder de modo previsível às variações do mundo real. Em relatórios técnicos e diretrizes amplamente adotadas, a ênfase recai sobre engenharia, verificação e validação. Em termos práticos, isso significa que a lógica deve ser testada não só no “caso feliz”, mas também em cenários degradados e em situações de fronteira (inputs nos limites, atrasos, mudanças de sequência, sinais oscilantes, perda intermitente de comunicação, etc.).
Para manter consistência terminológica, vale diferenciar:
O ponto crítico é que “orquestração por cenários” cria previsibilidade e reduz dependência de operadores para interpretar o que “deveria estar acontecendo”. Já a governança impede que o cenário se torne um objeto mutável e sem rastreabilidade. Em ambientes industriais maduros, a governança não é burocracia: é uma camada de proteção para manter a planta evoluindo com controle, e não “quebrando silenciosamente”.
Um Scenario Automação robusto costuma ser desenhado em camadas, reduzindo acoplamento entre componentes e facilitando testes, manutenção e evolução. Em geral, a complexidade do processo não deve “vazar” para dentro de decisões sem validação; e também não deve existir “magia” escondida em sinais sem diagnóstico. Quando o scenario é em camadas, você consegue evoluir cada parte com menor risco.
Esse desenho em camadas é importante porque, em incidentes reais, a causa raiz raramente é um comando errado isolado. Em geral, envolve: estados não tratados, sinais fora de faixa interpretados como válidos, falhas de sincronização, ausência de exceções, mudanças não governadas (por exemplo, ajuste de temporização sem atualização de documentação), e até erros “simples” como dependência de um evento que ocorre antes de o sistema estar pronto.
Uma forma de pensar isso: o scenario precisa ser resiliente. Resiliência não é “continuar funcionando apesar de tudo”; é continuar funcionando corretamente dentro de limites ou então falhar de forma segura e previsível. Isso vale tanto para segurança funcional quanto para integridade de produto e continuidade operacional.
Uma implantação bem-sucedida é sequencial e verificável. Do ponto de vista de engenharia, a ordem costuma ser: primeiro entender o processo e seus riscos; depois modelar estados e regras; depois integrar instrumentação; por fim testar com evidências antes de operar em produção.
Uma sequência prática (adaptável a cada planta) costuma incluir:
Observação: o “Scenario Automação” deve ser tratado como artefato de engenharia, não como simples configuração. Isso implica versionamento, revisão por engenharia, testes com evidências e documentação. Em plantas com histórico de incidentes, “configuração sem governança” é uma fonte recorrente de degradação ao longo do tempo: uma mudança pequena, sem rastreabilidade, vira uma falha intermitente meses depois.
Vale ainda destacar a diferença entre “comissionamento” e “instalação”. Instalar é colocar e ligar. Comissionar é provar que a lógica faz o que deveria fazer com critérios explícitos. Em projetos maduros, o comissionamento inclui também validação de comportamento em condições não ideais: por exemplo, quando um sensor passa a oscilar próximo ao limite; quando uma válvula tem histerese; quando a rede sofre perda momentânea; ou quando o operador altera o modo operacional durante uma fase de transição.
Como não foram fornecidos no pedido valores específicos de preço ou detalhes de fornecedor, este trecho foca na abordagem correta para comparar opções com base em critérios técnicos. Em projetos de automação, custos variam conforme escopo (software, instrumentação, elétrica, comissionamento, integração com sistemas legados, treinamento e suporte), além do nível de segurança exigido.
Um especialista recomenda organizar a decisão em três frentes, que refletem diretamente o risco e a capacidade de entrega:
Na prática, para evitar surpresas financeiras (e técnicas), peça que cada proposta deixe claro:
Além disso, em projetos reais, há custos indiretos que devem ser discutidos: o tempo de acesso a planta e bancada, o suporte de engenharia do cliente, a disponibilidade para testes com simulação de falhas, a necessidade de parada programada para FAT/SAT, e o esforço de treinamento em turnos. Muitas propostas “baratas” custam caro no total porque subestimam esses fatores.
Como estimar o custo total sem valores “fixos” de referência? Uma abordagem útil é decompor o escopo em entregáveis mensuráveis: por exemplo, “número de cenários”, “número de intertravamentos verificados”, “quantidade de casos de teste executados”, “quantidade de pontos de sinal documentados”, “profundidade de logs e auditoria”, e “quantidade de rodadas de comissionamento”. Você passa a comprar capacidade de validação, não apenas linhas de código ou “hardware instalado”.
Se a operação ocorre em contexto brasileiro, por exemplo, a integração e a validação podem enfrentar particularidades típicas: variação de disponibilidade de utilidades, heterogeneidade de instalações legadas (CLPs e redes antigas convivendo com sistemas novos), e necessidade de treinamento para equipes com diferentes turnos. Ainda que esses pontos sejam gerais, o impacto é concreto: o que “funciona no teste” pode falhar em produção por pequenas diferenças de ambiente, vibração, umidade, qualidade do sinal, ruído elétrico, estabilidade de fonte e aterramento.
Por isso, o Scenario Automação deve incorporar condições que reflitam o real: tempos de estabilização, tolerâncias, estratégias de degradação e mensagens claras para o operador. A automação ganha valor quando reduz a dependência de “conhecimento tácito” e transforma procedimentos em regras verificáveis. Em outras palavras, o scenario deve ser treinável e auditável: a equipe deve conseguir entender por que o sistema tomou uma decisão.
Um ponto frequentemente negligenciado é o comportamento em borda. Muitos processos têm limites operacionais estreitos: por exemplo, temperatura quase no setpoint, ou vazão perto do mínimo por minutos. Um cenário que só funciona “bem dentro das condições” tende a gerar falsos alarmes e paradas desnecessárias. Para evitar isso, a lógica precisa definir janelas e critérios de estabilidade, além de considerar histerese e filtros temporais adequados à física do processo.
Além disso, sempre que houver padronização visual e cultural interna (por exemplo, como a equipe local descreve “pronto”, “em lote” e “parada”), vale traduzir isso para a modelagem de estados. Isso reduz fricção na adoção do sistema. Se a linguagem do sistema diverge da linguagem operacional da planta, o operador passa a interpretar “no seu idioma”, criando risco de ação incorreta. A modelagem de estados e alarmes deve ser consistente com os procedimentos existentes ou com a atualização planejada desses procedimentos.
Outro aspecto do mundo real é a comunicação com sistemas adjacentes. Cenários raramente vivem isolados: eles dependem de eventos de lote, dados de qualidade, permissões de segurança, disponibilidade de utilidades e integrações com supervisão. Quando há latência ou diferenças de sincronização de relógio, a trilha de auditoria precisa refletir isso. Caso contrário, o diagnóstico vira uma disputa entre “qual evento chegou primeiro” e “quem causou o problema”. Uma estratégia robusta inclui sincronização de horário (NTP/PTP quando necessário), logs coerentes e mensagens com contexto.
| Item | Como comparar | Condições/Pré-requisitos | Critérios de aceite |
|---|---|---|---|
| Escopo do Scenario Automação | Verifique se a proposta descreve gatilhos, condições, ações e tratamento de exceções (não apenas sequência) | Mapeamento do processo e identificação de modos de falha prioritários | Lista de cenários aprovada e testada em casos normais e casos-limite |
| Qualidade de sinal | Compare estratégias de diagnóstico (ex.: faixa, plausibilidade, detecção de quebra, validação temporal) | Dados mínimos de sensores e histórico (quando disponível) | Testes com sinais fora de faixa e comportamento esperado documentado |
| Segurança operacional | Compare tratamento de estados seguros, intertravamentos e comportamento em perda de utilidades | Classificação de criticidade e requisitos de segurança aplicáveis ao processo | Validação de paradas seguras e auditoria do que disparou a ação |
| Rastreabilidade e auditoria | Compare se o cenário registra trilha de decisão (motivo do evento, variáveis relevantes, versão da lógica) | Definir campos e formato de log; sincronização de horário | Logs consultáveis e consistentes em testes de falha e retomada |
| Governança de mudanças | Compare processo de versionamento, revisão de requisitos e possibilidade de rollback | Planos de controle de mudanças e responsável por aprovações | Registro de mudanças e testes de regressão antes de atualizar em produção |
| Metodologia de testes | Compare planos de FAT/SAT, casos de teste e critérios de aceitação | Acesso a ambiente de simulação/teste ou bancada | Checklist de comissionamento com evidências e resultados |
| Treinamento e transição | Compare como o fornecedor treina operadores e manutenção no uso de cenários e alarmes | Rotinas operacionais e procedimentos atuais | Competência demonstrada (ex.: simulações de parada e recuperação) |
Para suplementar essa tabela, uma boa prática é transformar cada item em um artefato verificável. Por exemplo: “qualidade de sinal” não deve ser apenas “tem filtro”; deve haver definição do filtro, seus parâmetros e testes. “auditoria” não deve ser “tem log”; deve haver campos e trilha de decisão. E “governança de mudanças” não deve ser “tem controle”; deve haver plano de revisão, trilha de aprovação e testes de regressão para cada alteração relevante.
Quando você consegue comparar propostas em termos de evidência, você reduz a chance de escolher um fornecedor que promete alto desempenho, mas entrega somente o mínimo no comissionamento.
A seguir, um roteiro prático em formato de “passo a passo”, focado em reduzir falhas típicas de projetos de automação. A ideia é criar um método replicável: cada novo cenário começa com um modelo de estados sólido, valida sinais e já nasce com exceções e auditoria.
Além desses passos, uma recomendação importante é criar um catálogo de padrões para o time: padrões de nomenclatura, padrões de alarmes, padrões de estrutura de estados, padrões de tratamento de “sinal inválido”, padrões de mensagens ao operador. Quando o catálogo existe, o time implementa mais rápido e com menor risco de inconsistência entre cenários diferentes.
Outra recomendação prática é estabelecer “limites de complexidade”. Por exemplo: limitar o número de transições por estado, ou limitar o número de regras por cenário quando possível. Isso não é para simplificar por simplificar, mas para facilitar validação e reduzir probabilidade de interações não testadas entre condições.
Para que um Scenario Automação não vire “um emaranhado de exceções”, a engenharia deve manter disciplina em requisitos. O problema não é existir exceções; o problema é exceções sem estrutura, sem critérios e sem rastreabilidade. Quando as regras estão bem definidas, a exceção vira apenas uma rota alternativa do mesmo modelo.
Também é importante prever requisitos de interoperabilidade. O scenario deve saber o que fazer quando uma integração externa falha: quando um evento do MES não chega, quando dados de qualidade do lote chegam atrasados, quando uma comunicação com supervisório cai, ou quando um sistema de utilidades não responde em tempo. Sem isso, o scenario se torna vulnerável a falhas de infraestrutura, e não apenas de processo.
Outro requisito que frequentemente “some” em discussões iniciais é o tratamento de inicialização. Em planta, muitas falhas aparecem no início: após reset, após queda de energia, após mudança de modo, ou após recuperação de comunicação. Um scenario robusto define como ele se comporta ao sair de estados como “desconhecido”, “em inicialização” e “recuperação”. Isso evita que ações aconteçam antes de o sistema estar pronto.
Por fim, requisitos de mensagens ao operador não devem ser subestimados. Uma boa prática é que mensagens tenham: (a) ação esperada (o que fazer), (b) condição que precisa ser atendida, e (c) referência ao estado do processo. Uma mensagem vaga gera retrabalho e risco.
Em vez de buscar “promessas”, use métricas operacionais que instituições técnicas costumam acompanhar em sistemas de automação. Métricas devem refletir tanto desempenho quanto confiabilidade e qualidade da manutenção. Se você mede só “quantas vezes rodou sem falhar”, você perde sinais importantes como frequência de alarmes não acionáveis, tempo de recuperação e taxa de intervenções.
Para contextualizar por fontes, recomenda-se consultar guias de prática e normas técnicas relacionadas a segurança e confiabilidade em sistemas de automação. Entre referências amplamente utilizadas na indústria (dependendo do escopo), incluem-se documentos de organizações normativas e diretrizes de ciclo de vida para sistemas instrumentados e segurança funcional. Exemplos de entidades de referência incluem IEC (em suas séries aplicáveis) e relatórios técnicos de associações do setor (quando disponíveis publicamente). Caso você indique o setor (tintas, alimentos, farmacêutico, siderurgia, química, etc.) e o nível de segurança exigido, posso sugerir normas e diretrizes mais adequadas ao seu caso.
Além dessas métricas, vale considerar métricas de “qualidade de decisão”. Por exemplo: quantas vezes uma regra foi avaliada como verdadeira e executou ação com sucesso; quantas vezes uma exceção foi acionada e resolveu a situação sem parada total; quantas vezes a retomada foi possível sem reprocesso. Essas métricas conectam a engenharia de lógica com a experiência operacional.
Outro ponto: medir o custo de manutenção do cenário. Cenários que exigem intervenções frequentes, ajustes a cada semana, ou que geram exceções pouco compreendidas, tendem a elevar custo ao longo do tempo. Métricas de manutenção (tempo gasto, número de correções por cenário, retrabalho em validação) complementam indicadores de confiabilidade.
É uma forma de modelar a automação como um conjunto de cenários operacionais: gatilhos, condições, ações e tratamento de exceções. O foco é garantir que o processo execute corretamente conforme o estado e o contexto, com rastreabilidade e previsibilidade. Em vez de “programar tudo” como linha a linha, você define decisões e rotas com critérios explícitos.
Não necessariamente. Em geral, ele coordena a lógica entre componentes (sensores, CLPs, supervisão, sistemas de lote e utilidades). CLPs e supervisórios continuam sendo necessários; o cenário organiza o “como e quando” executar. Dependendo da arquitetura, o cenário pode rodar em um sistema de orquestração (servidor, runtime em plataforma, camada de software), enquanto o controle de tempo real segue no CLP.
Limite o número de estados e cenários ao essencial, mantenha regras testáveis, padronize nomes e severidades de alarmes, e implemente exceções com rotas claras. Além disso, governança de mudanças e revisão por engenharia são indispensáveis. Uma regra prática é: sempre que uma regra ficar difícil de testar, ela provavelmente não está bem definida ou está acoplada a sinais sem diagnóstico adequado.
Principais erros incluem: não tratar falhas de sensor, não definir comportamento em perda de utilidades, depender de eventos ruidosos sem validação temporal, não versionar lógica e alarmes genéricos que dificultam diagnóstico. Também é comum a falta de casos-limite no plano de testes, o que revela problemas somente após o início de operação.
Mesmo sem valores, você pode comparar escopo, maturidade de testes (FAT/SAT, casos-limite), rastreabilidade, documentação, abordagem de exceções e critérios de aceite. Quando houver preço, compare proporcionalmente ao que está incluso (comissionamento, treinamento, documentação, suporte e licenças). Se o fornecedor não consegue explicar o “como vai validar”, você deve tratar isso como um risco técnico.
Mapa de estados, lista de cenários, requisitos testáveis, matrizes de sinal (ponto a ponto), especificações de alarmes, estratégia de logs/auditoria, plano de testes e critérios de aceitação. Também é importante registrar premissas e limites. Documentação é parte da entrega porque habilita manutenção, auditoria e evolução.
Valide desde cedo com simulações e testes em ambiente de bancada, depois com FAT e SAT, e finalmente com validação assistida na entrada em operação. A ideia é reduzir riscos antes de chegar ao chão de fábrica. Validação cedo permite aprender sobre o processo (por exemplo, ruído do sinal, atrasos reais, histerese de atuadores) antes de “fechar” a lógica.
Sim. Uma prática comum é implementar primeiro cenários críticos ou de maior impacto operacional, garantindo que o modelo de estados e a governança de mudanças estejam sólidos. Depois, expande-se para casos adicionais conforme dados reais de operação. Começar pequeno reduz custo de aprendizado e facilita consolidar padrões internos.
Mudanças de requisitos devem ser tratadas como mudanças de engenharia, com rastreabilidade. Isso inclui atualizar requisitos, ajustar regras e estados, executar testes de regressão e registrar evidências. Sem isso, o scenario pode divergir da especificação, e o time perde capacidade de diagnosticar incidentes.
Rollback é a capacidade de retornar a uma versão anterior do scenario (ou de um conjunto de regras) de forma controlada, preservando segurança e integridade do processo. Para ser efetivo, o rollback precisa ser testado e integrado à governança de mudanças. Caso contrário, você tem “rollback teórico”, que falha no momento crítico.
Um Scenario Automação bem construído transforma automação em engenharia de decisão operacional: melhora previsibilidade, reduz variabilidade entre turnos, acelera diagnóstico e torna mudanças mais seguras. Em vez de tratar a automação como “sequências prontas”, o cenário cria um mapa de intenção com tratamento de exceções, rastreabilidade e requisitos testáveis—o que, na prática, sustenta estabilidade e evolução contínua.
O valor real aparece quando: (1) a lógica responde consistentemente às variações do mundo real, (2) o operador entende por que o sistema agiu como agiu, (3) o time de manutenção consegue corrigir com evidência, e (4) a engenharia consegue melhorar sem introduzir riscos ocultos. Isso é particularmente relevante em plantas onde a operação é intensa, os turnos alternam frequentemente e há histórico de pequenas falhas que custam caro ao longo do tempo.
Se você quiser, compartilhe o setor (ex.: alimentos, embalagens, química, logística), o tipo de processo (batch, contínuo, discreto), e quais sistemas já existem (CLP, supervisório, MES, ERP). Com isso, posso adaptar um modelo de estados e um conjunto inicial de cenários com requisitos e critérios de teste mais alinhados ao seu cenário real.



This guide explains how to evaluate SKU 750816 procurement and supplier fit for consistent quality and predictable lead times. Objectively, the keywords relate to identifying a specific item, comparing supplier capabilities, and validating sourcing conditions using documented specifications, commercial terms, and traceable documentation. The focus is practical decision-making grounded in standard supply-chain due diligence.
This guide explains how to approach Fygf with a disciplined sourcing method, focusing on pricing logic and supplier due diligence. Objectively, Fygf is treated here as a procurement-related keyword representing a specific product or service category. Background coverage clarifies how market pricing, lead times, documentation, and quality controls connect—so decisions can be made with confidence.
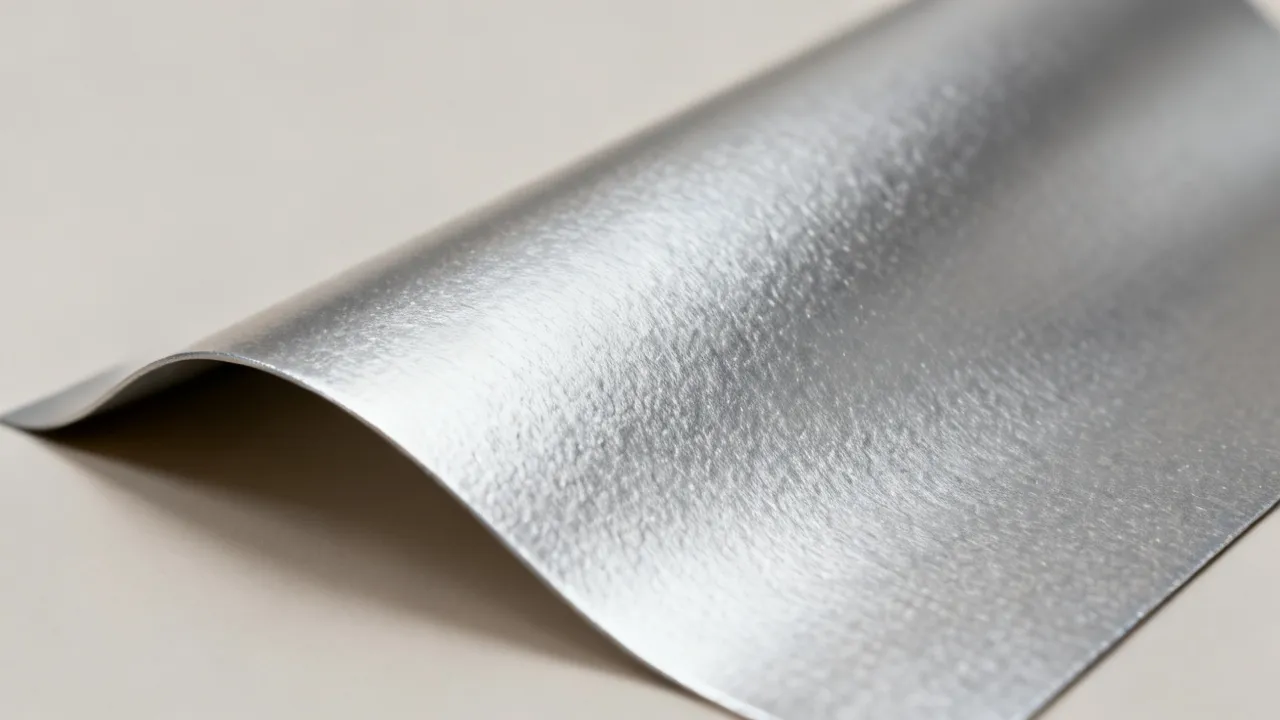
Fulepelata es un material metálico con aplicaciones decorativas e industriales donde importan el acabado, el espesor y la trazabilidad. Este documento explica, de forma objetiva, qué significa el término, por qué se valora en talleres y proyectos, y cómo comparar calidades al solicitar cotizaciones, junto con requisitos habituales de compra, criterios de recepción y preguntas frecuentes para una decisión informada.
Este guia explica, de forma objetiva, como funciona a gestão e organização de informações ligadas ao GSN Contagem, destacando boas práticas, critérios de escolha e cuidados essenciais. Em seguida, contextualiza o termo no ambiente corporativo, discutindo por que empresas utilizam padronização e controles para reduzir riscos operacionais e melhorar a governança.
This guide explains how to evaluate Uu-related pricing and supplier options with a disciplined, risk-aware approach. Objectively, “Uu” functions as a label used across procurement and product catalogs to reference a specific item set or internal code. The article outlines sourcing criteria, supplier validation, and decision conditions for consistent outcomes.
This guide explains how “9i” and related terms—especially “ ”—can be evaluated for smart sourcing decisions, with an objective lens on what to verify before choosing a supplier. It outlines background context, selection criteria, and practical workflows so teams can compare options consistently, manage requirements, and reduce procurement risk while maintaining quality standards.

